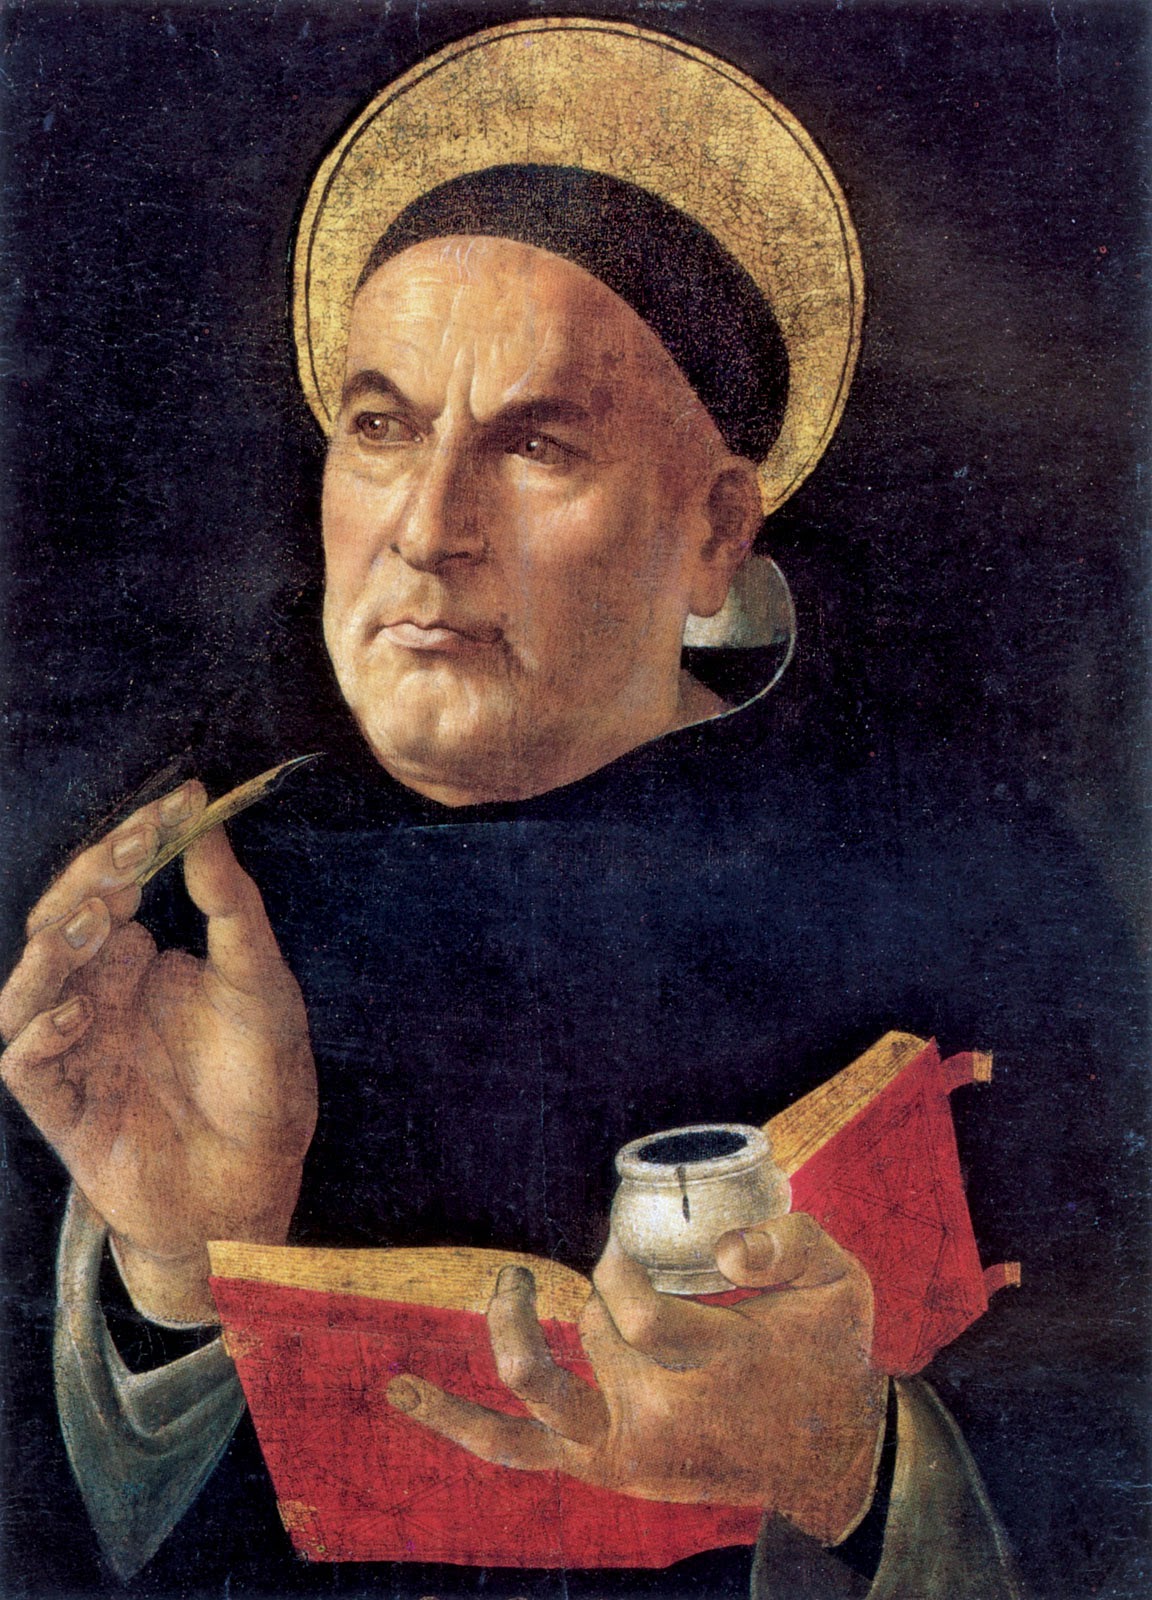
Se nel 1945 vedeva la luce il primo gigantesco calcolatore moderno riprogrammabile, l’Eiac (Electronic Numerical Integrator and Computer), il primo uomo al mondo che ha pensato di impiegare un simile congegno per delle analisi linguistiche – invece che per i calcoli numerici – è stato l’italiano Roberto Busa, un gesuita studioso di Tommaso d’Aquino. La sua intuizione risale al 1946, ed è ben documentabile. Con questi strumenti – si interrogava – sarebbe stato possibile catalogare l’intero corpus tomistico (circa 11 milioni di parole) per creare degli indici consultabili e un sistema di ricerca per parola?
Si trattava di un’idea così folle, per l’epoca, che nel 1949, quando lo studioso riuscì a farsi ricevere dal fondatore dell’Ibm Thomas J. Watson per illustrargli il progetto si sentì rispondere che i giganteschi mainframe dell’epoca erano in grado di elaborare i numeri, non le parole. Il gesuita riuscì però a convincerlo della bontà dell’impresa, e Watson – dopo averlo pregato di non far trapelare la notizia che l’Ibm si sarebbe trasformata “in un’opera di carità” – finanziò il progetto e gli mise a disposizione le macchine e una squadra di ingegneri. Anche perché quella strana prospettiva avrebbe potuto aprire nuove promettenti strade sull’impiego dei calcolatori (come poi sarebbe avvenuto).
Busa si trasferì perciò a New York, e cominciò a lavorare manualmente per codificare e digitalizzare ogni parola sulle schede perforate di allora. L’idea era quella di “lemmatizzare” le opere in latino di San Tommaso, e cioè di marcare sotto uno stesso codice numerico non solo ogni singolo termine, ma anche le forme declinate, in modo che fosse possibile rintracciare le flessioni di uno stesso vocabolo – per esempio faces (“fiaccola”, nominativo plurale di fax, facis) – e persino distinguere gli omografi, così che faces (il futuro del verbo facio, “tu farai”) non si potesse confondere con il sostantivo. Il prototipo di questa prima stesura, che dimostrava che il progetto funzionava, fu stampato su carta nel 1951.
Fu il primo testo al mondo elaborato da un calcolatore, e conteneva gli indici di tutte le parole codificate con la loro frequenza (quante volte comparivano e dove) e anche con le concordanze (le righe che le contenevano per comprenderne il contesto). Anche se riversato su carta, questo lavoro era in altre parole il primo ipertesto mai realizzato, benché non si chiamasse ancora così.
La parola ipertesto (hypertext) sarebbe stata coniata solo successivamente da Ted Nelson, nel 1965, che a quanto pare ignorava l’esistenza del lavoro di Busa, e per definire quel concetto si era invece ispirato a uno scritto del 1945 di un ingegnere (Vannevar Bush, “As We May Think”) che aveva ipotizzato una macchina tutta teorica (il Memex) fatta di schermi translucidi, in grado di associare pagine di libri diversi riversati su diapositive. Nelson vide nel calcolatore uno strumento concreto per realizzare quel sogno, e ne delineò i fondamenti con il progetto Xanadu, sfociato in un programma per realizzare questi collegamenti (seguito dal libro Literary Machines, 1982). Anche se nei manuali d’Oltreoceano l’invenzione dell’ipertesto è legata a queste due figure, il Memex era solo un’ipotesi, non un prototipo; non aveva nulla di digitale ed era fuori da ogni logica dei precursori del computer.
Dunque, fare di Bush un anticipatore dell’ipertesto è qualcosa che ha senso nella ricostruzione della genesi delle idee di Nelson, più che nella storia della linguistica computazionale (di cui oggi Busa è riconosciuto come il padre). E mentre si elaboravano simili altisonanti concetti teorici, Roberto Busa aveva già da tempo realizzato concretamente – seppure partendo da diverse prospettive – quello che altri stavano ancora teorizzando.
E infatti, proprio seguendo la via aperta da Busa, nel 1965 (mente Nelson coniava “ipertesto”) in Italia fu realizzato un analogo indice con il lemmario, le concordanze e le rime della Divina Commedia, realizzato con i medesimi criteri dal linguista Carlo Tagliavini e dall’Ibm italiana.
Se il prototipo del 1951 – un volumetto di sole 175 pagine – conteneva solo gli inni liturgici di Tommaso, successivamente il lavoro di digitalizzazione fu esteso a tutte le altre opere. Fu un’impresa certosina e ciclopica che durò ben 25 anni. Produsse milioni di schede perforate, tonnellate e tonnellate di cartoncini dall’ingombro esagerato che furono poi stoccate nei capannoni di Gallarate dove Busa aveva trasferito il centro di calcolo.
Intanto anche i calcolatori si evolvevano, e dopo l’epoca delle schede perforate i dati vennero continuamente riversati sui nuovi supporti come i nastri magnetici (che complessivamente si snodavano per 1.500 chilometri), per poi essere convertiti in caratteri tipografici pronti per la stampa. In questo modo il primo dei 56 volumi cartacei che ne sarebbero derivati fu stampato nel 1974, e l’ultimo uscì nel 1980 (in totale si trattava di 70.000 pagine).
Nel frattempo anche la necessità di un’attività umana si era ridotta sempre più, sostituita dal lavoro macchina sempre più sofisticato. Nel 1989 tutta quella mole di dati – un ipertesto su carta – fu finalmente riversata su un cd-rom, cioè in un solo dischetto consultabile grazie a un motore di ricerca, invece che seguendo gli indici cartacei. L’opera fu poi commercializzata nel 1992 dalla Editel di Milano, dove la parola “ipertesto” veniva chiaramente enunciata anche nel titolo: Thomae Aquinatis Opera Omnia cum Hypertextibus in CD-ROM.
Ma dal 2005 tutto è ormai disponibile sul web.
Antonio Zoppetti* @tutti i diritti riservati
*Antonio Zoppetti ha collaborato con Roberto Busa alla pubblicazione del cd-rom del 1992 e nel 2003 ha per la prima volta ricostruito questa storia dell’ipertesto tutta italiana nel libro Blog. PerQuenau? La scrittura cambia con Internet (Luca Sossella Editore).
Tags: alberto busa, antonio zoppetti, ibm, ipertesto, tommaso d'aquino